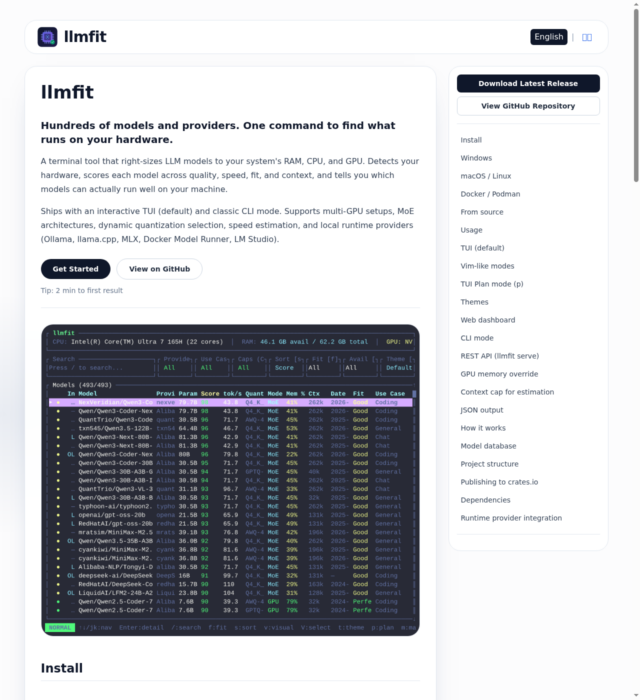
¿Alguna vez descargaste un modelo de lenguaje para correrlo en tu propia computadora y terminaste con la máquina congelada, o con el modelo respondiendo palabra por palabra cada varios segundos? Ahí es donde entra llmfit, una herramienta de terminal que revisa el hardware de tu equipo y te dice, antes de que descargues nada, qué modelos vas a poder correr bien y cuáles simplemente no te van a funcionar.
La herramienta detecta automáticamente los núcleos de CPU, la RAM disponible, la GPU (dedicada o integrada) y su VRAM, e identifica si tu sistema corre sobre CUDA de NVIDIA, Apple Silicon, ROCm de AMD u OneAPI de Intel. Con esos datos consulta su propia base de modelos, tomada de Hugging Face, y calcula para cada uno qué tan bien va a rendir en tu máquina específica.
Lo interesante es que no se limita a decir «sí» o «no». llmfit califica cada modelo según calidad, velocidad estimada, compatibilidad y tamaño de contexto, y elige automáticamente la cuantización y el modo de ejecución que mejor aprovechan tu hardware. Por defecto abre una interfaz de terminal (TUI) interactiva, con navegación estilo Vim, donde puedes buscar, filtrar y ordenar entre cientos de modelos disponibles; si prefieres algo más simple, también trae un modo de línea de comandos clásico.
Una vez que decides qué modelo correr, llmfit no lo ejecuta él mismo, sino que se integra con los motores locales más usados, como Ollama, llama.cpp, MLX (para Apple Silicon), Docker Model Runner y LM Studio. También trae un panel web y una API REST propios, para quien prefiera explorar los modelos desde el navegador o integrarlos en otro proyecto.
Instalación y comandos principales
Está escrita en Rust, es de código abierto bajo licencia MIT, y tiene varias formas de instalarse según tu sistema:
- Homebrew (macOS/Linux):
brew install AlexsJones/llmfit/llmfit. - Script de instalación rápida (macOS/Linux), con el comando de abajo.
- Scoop (Windows):
scoop install llmfit. - Docker:
docker run -it --rm ghcr.io/alexsjones/llmfit --tui. - Python/uv:
uv tool install -U llmfit. - O compilarla desde el código fuente con Cargo.
curl -fsSL https://llmfit.axjns.dev/install.sh | sh
llmfit doctor
llmfit recommend
Una vez instalada, estos son los comandos que más vas a usar:
llmfit: abre la interfaz interactiva (TUI).llmfit doctor: reporte de detección de tu hardware.llmfit recommend: recomendaciones basadas en tu equipo (agrega--jsonpara obtener la salida en bruto).llmfit fit: tabla de modelos ordenada por compatibilidad.llmfit info "<modelo>": análisis detallado de un modelo específico.llmfit bench: mide el rendimiento real en tu equipo.llmfit serve: levanta el panel web y la API REST enlocalhost:8787.
Si ya usas Ollama o LM Studio para correr modelos en tu propia computadora, seguramente te ha tocado adivinar si un modelo de 30B o 70B realmente le entra a tu RAM antes de descargar varios gigabytes para nada. Llevo poco probando llmfit, pero la idea de resolver esa duda con un par de comandos, en los 2 minutos que prometen sus propios desarrolladores, me parece de lo más práctico que le he visto a este ecosistema en los últimos meses. Con más de 35 mil estrellas en su repositorio de GitHub y actualizaciones activas, vale la pena tenerla a la mano si trabajas con modelos de IA de forma local.